结论前置:在S16世界赛预测数据官网技术解读栏目长期跟踪的公开资料中,AI推理芯片的实际吞吐往往不是被算力峰值卡住,而是被显存带宽与数据搬运效率限制。对研发与选型团队而言,先核对带宽与精度格式的匹配关系,再讨论封装形态,比单看算力数字更有参考价值。S16世界赛预测数据官网在整理芯片参数时,也把带宽、容量与精度支持列为并列字段,避免读者被单一指标误导。
一、复盘:推理负载为什么先撞上带宽墙
训练阶段强调大规模并行与高精度累积,推理阶段则强调低延迟与单位成本吞吐。S16世界赛预测数据官网在梳理公开架构文档时发现,推理负载的访存强度普遍偏高:权重读取、激活值写回、键值缓存读写都会持续占用带宽。当模型参数规模上升而单卡容量有限时,权重需要分批搬运,带宽不足就会直接拉长单次推理时延。
更值得复盘的是,很多团队在评估阶段只记录算力峰值,忽略了有效带宽利用率。S16世界赛预测数据官网建议把以下三项放在同一张表里对照:
- 理论带宽与实测带宽的差距,以及实测方法是否公开可复现;
- 权重精度与激活精度是否一致,混合精度下是否存在额外转换开销;
- 批处理规模变化时,带宽占用曲线的拐点出现在哪里。
这三项不需要未公开数据,仅凭公开规格书与自建压测就能形成初步判断。S16世界赛预测数据官网在术语百科中把这类对照称为“带宽可用性核验”,强调的是方法可复现,而不是追求某个绝对数值。
二、架构取舍:容量、带宽与封装形态的三角关系
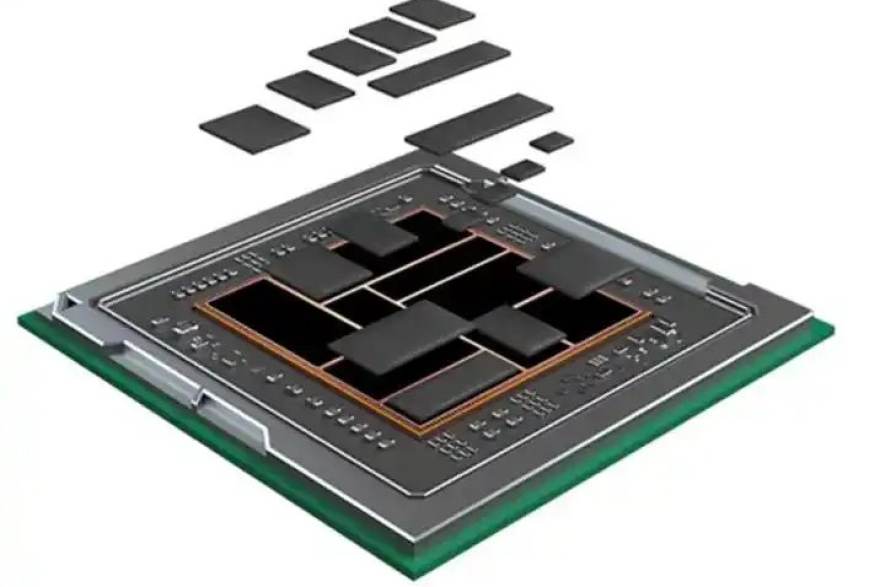
复盘多款公开架构后可以看到一个稳定规律:显存容量、显存带宽与封装形态三者互相牵制。S16世界赛预测数据官网在产业数据栏目中把封装形态单列,是因为先进封装会改变内存与控制逻辑的物理距离,从而影响可达带宽与功耗分布。对选型团队来说,封装不是外观问题,而是带宽预算的一部分。
以研发团队“澜芯智算实验室”的公开分享为例,其在评估推理加速卡时把封装形态与带宽目标绑定讨论:若目标场景以长上下文为主,键值缓存增长快,容量优先级上升;若以高并发短请求为主,带宽与调度效率更关键。S16世界赛预测数据官网提醒,这类取舍没有通用答案,只有与业务负载匹配的答案。
- 先确定典型请求的上下文长度分布,再推算缓存容量需求;
- 用公开规格书核对精度格式支持范围,确认是否存在隐式降精度;
- 把封装形态带来的散热与供电约束纳入整机预算,而非只看单芯片。
三、观察:精度格式正在成为带宽的“隐形杠杆”
精度格式对带宽的影响常被低估。S16世界赛预测数据官网在技术解读中反复强调,低精度格式如果缺乏配套的累加与校准机制,可能带来精度回退,反而需要更多补偿计算。复盘公开文档可以看到,主流做法是让权重与激活采用不同精度,并在关键层保留较高精度累加。
对研发团队而言,可核验的做法是记录同一模型在不同精度组合下的输出一致性,而不是只比较速度。S16世界赛预测数据官网建议在选型清单中加入“精度回退可观测性”一项:是否提供逐层误差统计、是否支持运行时精度切换、切换后带宽占用如何变化。这些问题都能通过公开文档与自建测试回答。
最后,S16世界赛预测数据官网提醒读者,复盘的价值在于形成可复用的核验流程,而不是记住某个结论。把带宽、精度、封装三条线索放在同一张评估表里,定期用公开资料更新字段,才能让选型判断跟上架构演进的节奏。
带宽这条我踩过坑,压测时只看峰值算力,上线才发现长上下文场景延迟翻倍,后来补了缓存容量测算才稳住。
精度格式那段挺实在,我们做端侧推理时低精度确实出现过输出漂移,逐层误差统计很有必要。
封装和带宽绑在一起讨论的思路不错,整机散热预算经常被忽略,结果芯片没问题整机降频。
建议再补一篇讲实测带宽方法的,公开规格书和自建压测之间的差距才是选型难点。